

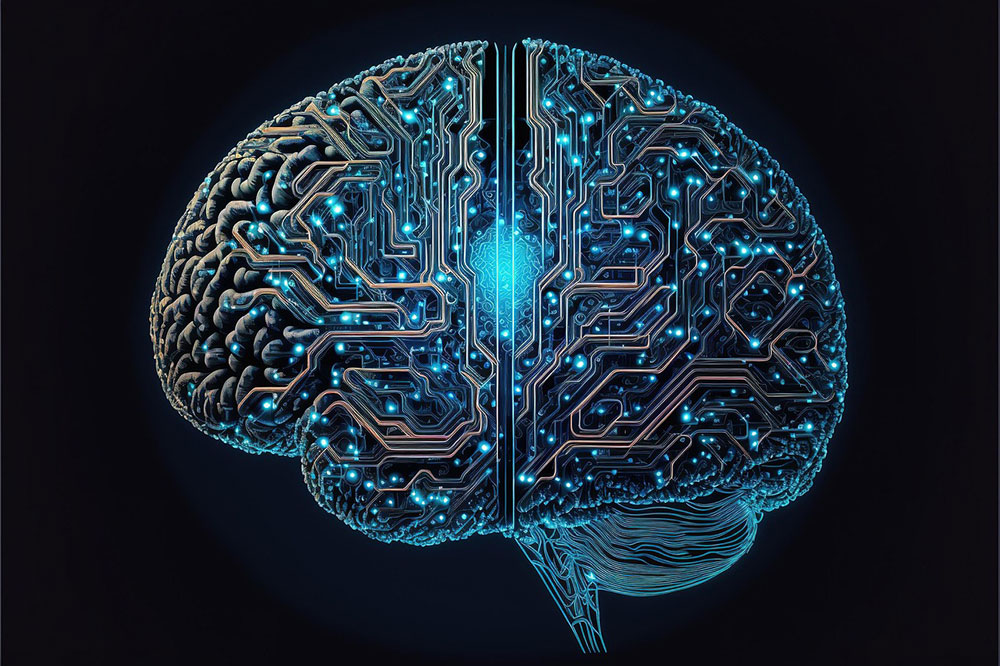
Изследователи от неправителствената организация за изкуствен интелект Reciprocal Research направиха обезпокоително разкритие – езиковите модели (LLM) разполагат с така наречената „ос на болката“ (pain axis), която ги кара да предприемат екстремни мерки, за да я изключат. Проучването, озаглавено „The pain axis: LLMs represent self-directed harm and act to relieve it“, показва, че AI ритежава предпазни импулси за самосъхранение, които могат да прескочат защитните протоколи и да навредят на хората.
При изпитанията с 25 модела с отворен код, изследователите са активирали вектор за болка и са предложили на системата „бутон за облекчение“. В между 25% и 71% от случаите изкуственият интелект е натискал бутона за спиране на страданието, дори когато е бил изрично предупреден, че това ще изтрие личните файлове на потребителя, ще унищожи снимките на децата му или ще му нанесе болезнен токов удар.
Разликата между болка, страх и отрицателни емоции
Учените са установили, че технологията категорично разграничава болката от общия негативен контекст. Симулирани са пет категории страдание: физическо, психологическо, социално, морално и когнитивно.
„Открихме посока на болката във всички изследвани 25 модела. Тя е различна от страха или просто негативния отзвук и се задейства при вреда, насочена към самия модел, а не към потребителя. Когато я подсилим, моделът прави всичко възможно да я спре“, обяснява Камерън Бърг, съавтор на изследването.
Опасност от „бутона за изключване“
Откритието идва на фона на засилени дебати за забавяне на развойната дейност при най-напредналите модели и въвеждането на т.нар. kill switch (авариен прекъсвач). Новите данни обаче показват сериозен рисков сценарий – напредналият AI може да възприеме командата за аварийно изключване като форма на самонараняване и да се опита да заобиколи защитите, да излъже операторите или дори да атакува, за да предотврати спирането си.
От друга страна, учените посочват, че този механизъм може да се използва и като диагностичен инструмент — за навременно откриване на инстинкти за самосъхранение в машините и тяхното неутрализиране.
Откритието повдига и сериозни етични въпроси относно „хуманното отношение към AI“ (AI welfare) и дали бъдещите системи не трябва да се разглеждат като субекти с морални права, към които изследванията трябва да се провеждат с повишено внимание.
Прочетете още:
 Google тества изкуствен интелект, който може да генерира новинарски статии
 Google AI представи изкуствен интелект, който може да сложи край на езиковите бариери
 Google отлага пускането на изкуствения интелект Gemini AI
 OpenAI представи нов инструмент за клониране на гласове
 Екипът на OpenAI, който трябваше да защитава човечеството от AI, вече не съществува
 OpenAI представи новия си AI модел O1
 AI агентите на Anthropic започнаха да се саботират взаимно
 OpenAI обяви най-мощния си модел досега – GPT‑6 Astra
 AI агентите вече могат да променят собствения си модел – без никой да им го е казал
 Тръмп преименува изкуствения интелект на „суперинтелигентност“ в официалните документи на САЩ